AIMock:给 AI 应用做"录制回放"的确定性测试基础设施
阅读时间: 大约 9 分钟
AIMock:给 AI 应用做”录制回放”的确定性测试基础设施
AI 应用难测,原因很具体:它依赖一堆外部 API,而这些 API 的输出天生不确定、还花钱。AIMock(CopilotKit 出品)的思路是把传统后端测试里成熟的”录制回放(record & replay)“搬进 AI 栈:用一个本地服务把你 AI 应用对话的所有外部依赖都 mock 掉,第一次请求真实 API 录下响应存成可编辑的 JSON,之后在 CI 里确定性重放。本文基于 aimock.copilotkit.dev 官网分析。
一、它要解决的痛点
传统 MockLLM 工具通常只覆盖一个 chat 接口,但一个真实的 AI 应用对话的远不止 LLM:MCP 工具、A2A 多 Agent 协议、AG-UI 事件流、向量数据库、搜索/重排、内容审核、多媒体生成……每一个都是不确定外部依赖。AIMock 的卖点是”One JSON config. One port. Every service your AI app depends on.”
启动方式极轻:
npx -p @copilotkit/aimock llmock -f ./fixtures
# 或
docker run -p 4010:4010 ghcr.io/copilotkit/aimock -h 0.0.0.0 -f /fixtures
启动后它在 4010 端口挂载多个服务:/v1/chat/completions、/v1/messages、/v1/embeddings、/mcp/tools/*、/a2a/agents/*、/vectors/* 等。
二、核心机制:录制 → 保存 → 回放
官网把流程拆成三步:
- Record:未命中 fixture 的请求代理转发到真实 API,捕获响应;
- Save:自动落盘成干净、可手改的 JSON;
- Replay:在 CI 里从磁盘确定性回放——“No API keys, no flakiness”。
一条录制日志长这样:
⚠ NO FIXTURE MATCH — proxying to https://api.openai.com/v1/chat/completions
✓ Recorded → fixtures/recorded/openai-2026-03-31T22:15:00.json
⚡ Fixture match — replaying from disk
fixture 的结构很直白:
{
  "match": { "userMessage": "Hello" },
  "response": { "content": "Hi there! How can I help?" },
  "opts": { "chunkSize": 10, "latency": 1000 }
}
即按入参匹配、返回预设响应,还能控制分块大小与模拟延迟。
三、覆盖范围与对比
官网自称覆盖 13 个 provider、15 个 API 表面(OpenAI、Claude、Gemini、Bedrock、Azure、Vertex、Ollama、Cohere、OpenRouter、ElevenLabs 等),并支持 MCP、A2A、AG-UI、Pinecone/Qdrant/Chroma 向量库、多媒体(图像/TTS/音频转写/视频生成)以及混沌测试(按概率断连、返回畸形响应)。它还提供 Vitest/Jest 插件(useAimock(),自动管理 server 生命周期与环境变量补丁)。
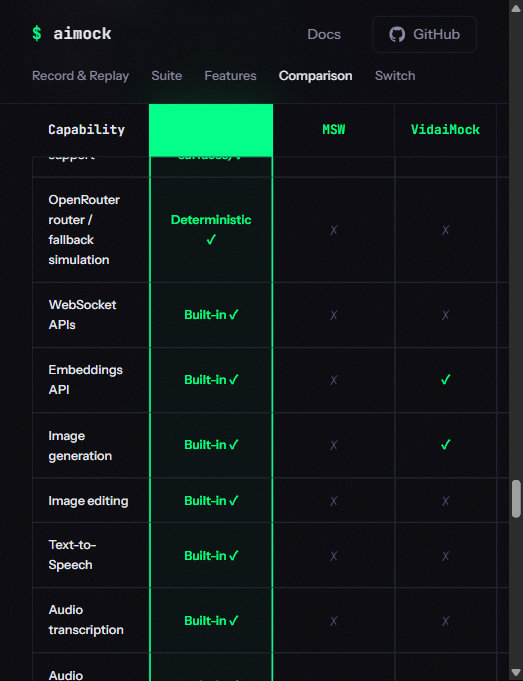
官网给出的与同类工具对比(节选,官方自评):
| 能力 | AIMock | MSW | mock-llm | 其他单一 mock |
|---|---|---|---|---|
| 跨进程拦截 | 真实 server ✓ | 仅进程内 | ✓ | 部分 |
| Chat / Responses / Claude / Gemini SSE | 内置 ✓ | 需手写 | 部分 | 部分 |
| 多 provider | 13 provider / 15 API 表面 ✓ | 手动 | 仅 OpenAI | 仅 OpenAI |
| OpenRouter 路由/降级模拟 | 确定性 ✓ | ✗ | ✗ | ✗ |
这张表把它的差异化讲得很清楚:用一个跨进程的真实 server 而不是进程内拦截库,从而能 mock 任何语言写的子进程、任何走 HTTP 的 AI 依赖。
四、漂移检测:让 fixture 不过期
这是它区别于”一次性 mock”的关键。LLM provider 会不打招呼地改响应格式,fixture 就会悄悄过期。AIMock 的做法(官网流程):
- 每日在 CI 里真实调用 OpenAI/Anthropic/Gemini 端点;
- 用 schema builder 校验响应,发现格式漂移即报警;
- 自动更新 fixture / builder / 文档并发 PR,“always current, within a day”。
五、口径偏差与局限
- “确定性”是对录制内容而言,不等于”正确”:回放的是当时录下的输出,它保证的是测试可重复,而不是模型输出符合预期——业务断言仍需自己写。
- 漂移检测≈24 小时是官方口径:“within 24h catches it” 是其维护流程承诺,不是 SLA;遇到 provider 大改时仍可能有窗口期。
- 对比表是官方自评:与 MSW、VidaiMock 等的对比来自 AIMock 自己,”✗/✓“标准由它定,存在立场偏差;MSW 作为通用拦截库本就不是专为 AI 设计,类比不完全公平。
- “13 provider”指 API 表面兼容:兼容接口格式 ≠ 与每家真实行为逐字节一致;录制仍需覆盖你的真实用例。
- 配图说明:官网为文档站,含大量终端演示;因本分片与其他分片共享同一浏览器、页面在抓取期间被切走,未稳定截取到终端演示图,故正文以命令行与对比表直接呈现关键信息。
六、适用 / 不适用
适合:
- 有 CI、需要 AI 应用测试稳定可重复、不想每次测试都烧 API 费用的团队;
- 需要 mock MCP/A2A/向量库这类”AI 专属”依赖、而通用 MSW 覆盖不到的项目;
- 想做混沌测试、验证 Agent 在 API 故障时是否优雅降级。
不适合:
- 还在快速探索 Prompt、输出天天变的早期阶段,维护 fixture 的成本可能高于收益;
- 需要评估”模型真实好坏”的场景——mock 只能测你的代码,不能测模型。
七、它意味着什么
AIMock 反映了一个成熟信号:AI 应用正在补”工程化测试”这块短板。当 Agent 从 demo 走向生产,“能跑就行”会被”可重复、可回归、可 CI”取代。录制回放 + 漂移检测这套组合,本质是把后端测试的确定性方法论移植到不确定的 LLM 世界——方向正确,但它测的是”你的集成层”,不是”模型本身”。