agent-browser:Vercel Labs 给 AI Agent 用的无头浏览器 CLI,用无障碍树引用代替 CSS 选择器
阅读时间: 大约 15 分钟
agent-browser:Vercel Labs 给 AI Agent 用的无头浏览器 CLI,用无障碍树引用代替 CSS 选择器
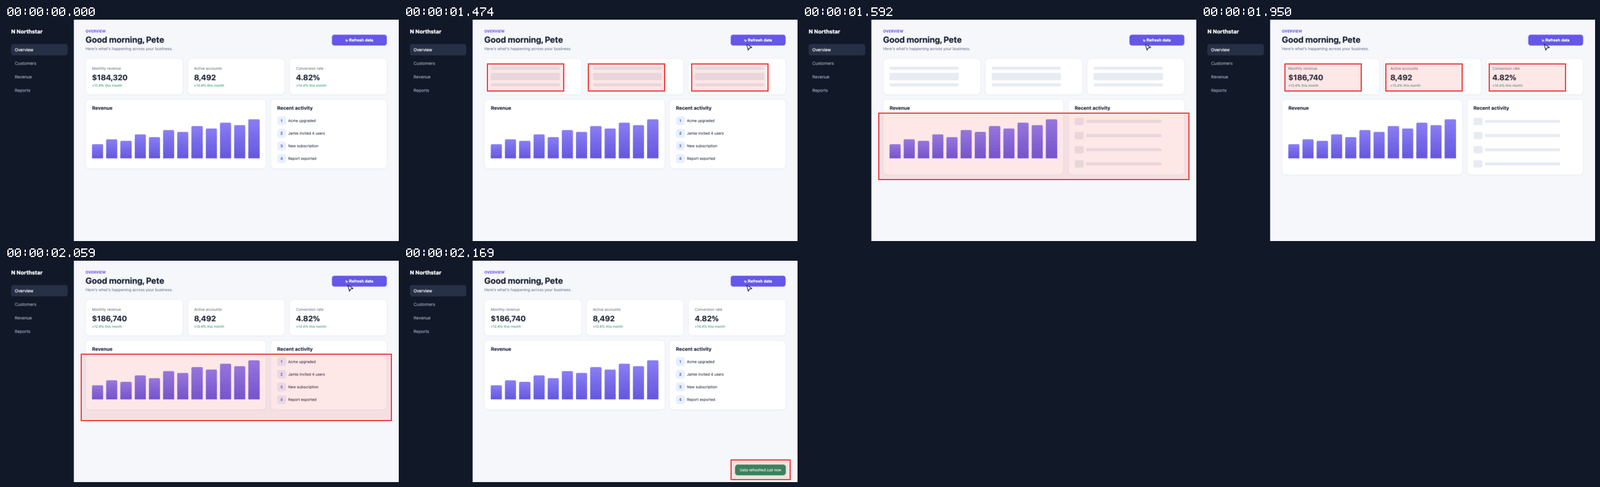
agent-browser 是 Vercel Labs 推出的浏览器自动化命令行工具,开源在 GitHub(Apache-2.0),npm 包名为 agent-browser。它面向的使用者不是写脚本的前端工程师,而是 AI Agent:模型不需要自己构造脆弱的 CSS 选择器,而是读取一份带引用编号的无障碍树(accessibility tree),用 @eN 这样的引用直接点击、填写元素。本文基于其 GitHub README、官方文档站 agent-browser.dev 与 npm 元数据做一手核对。
一、背景动机:让 Agent 操作网页,卡在”怎么指代元素”
主流浏览器自动化方案(Playwright、Puppeteer 等)以 CSS 选择器、XPath、文本匹配定位元素,这套方法为人写脚本设计,交给大模型时存在两个老问题:一是页面类名经常被构建工具混淆,选择器脆弱;二是模型每次都要把整棵 DOM 塞进上下文,token 开销大,且容易被无关节点干扰。
agent-browser 的出发点是把”定位”这件事从 DOM 结构里抽象出来:CLI 先把页面压缩成一棵只含交互元素、每个元素带稳定临时引用的树,Agent 读这棵树发指令,CLI 再把引用翻译成浏览器操作。官方文档站给出的口径是,snapshot 文本输出约 200–400 tokens,而整份 DOM 约 3000–5000 tokens(官方估算,非独立基准,实际随页面复杂度变化)。
二、是什么:Rust CLI + 纯 Rust daemon 的 client-daemon 架构
README 的 Architecture 一节明确采用 client-daemon 结构:
- Rust CLI:负责解析命令、与 daemon 通信;
- Rust Daemon:纯 Rust 实现,通过直接 CDP(Chrome DevTools Protocol)控制浏览器,不需要 Node.js 运行时。
daemon 在第一条命令时自动启动并在命令之间常驻,后续命令复用已开的浏览器以降低启动开销。需要注意:从源码构建才要求 Node.js 24+、pnpm 11+ 与 Rust;普通用户走 npm install -g agent-browser 安装原生分发即可,daemon 本身不依赖 Node。
安装后首次运行 agent-browser install 会从 Chrome for Testing(Google 官方自动化通道)下载 Chrome,也会自动探测已有的 Chrome、Brave、Playwright、Puppeteer 安装。
| 项目 | 官方口径 |
|---|---|
| 协议 | Apache-2.0 |
| 分发 | npm 包 agent-browser;亦提供 Cargo 安装 cargo install agent-browser |
| 默认引擎 | chrome;可选 lightpanda、obscura(experimental) |
| 守护进程 | 纯 Rust,直接 CDP,无 Node.js 依赖 |
| 默认空闲超时 | 1 小时(--idle-timeout 可调,0 关闭) |
| 本地仪表盘默认端口 | 4848 |
| 内置无障碍审计引擎 | axe-core 4.12.1 |
三、技术机制:snapshot 无障碍树 + @eN 引用 + 引用生命周期
核心命令是 agent-browser snapshot。它不输出 HTML,而是输出一份紧凑、面向 AI 的无障碍树:
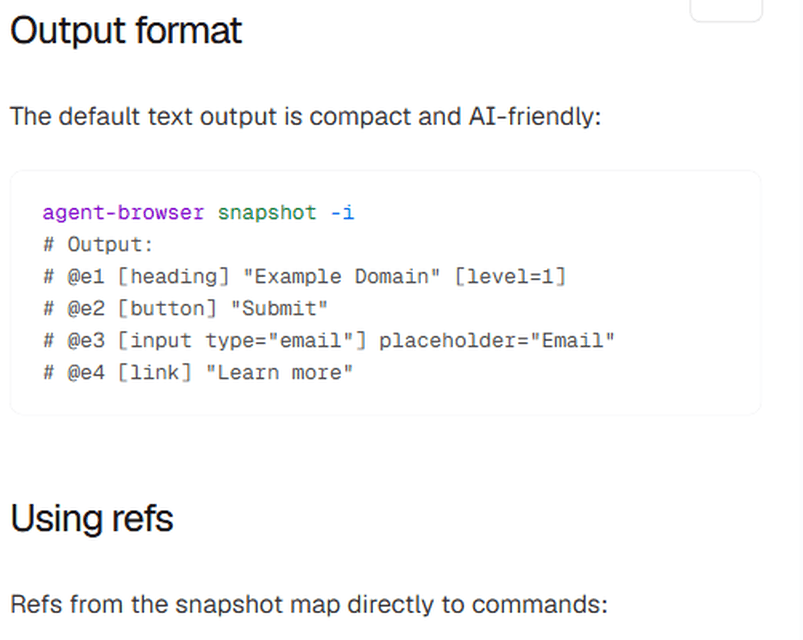
agent-browser snapshot -i
# Output:
# @e1 [heading] "Example Domain" [level=1]
# @e2 [button] "Submit"
# @e3 [input type="email"] placeholder="Email"
# @e4 [link] "Learn more"
随后 Agent 直接用引用发指令:
agent-browser click @e2
agent-browser fill @e3 "a@b.com"
agent-browser get text @e1可选过滤器用来进一步压缩输出:-i 只列交互元素(按钮、链接、输入框,官方推荐)、-u 附带链接 href、-c 删除空结构、-d N 限制深度、-s "#main" 限定选择器范围;--delta 首次返回全量,之后只回 unchanged 或结构化增量。
引用生命周期是这套机制容易被忽略的细节:存活的 DOM 元素在多次 snapshot 和同文档更新之间保留引用;元素被替换、页面或 iframe 导航后引用即失效且不回收 ID;虚拟无障碍节点的引用只在当前 snapshot 内有效。因此官方要求导航后必须重新 snapshot。
围绕核心机制,CLI 还提供:
- Annotated screenshots:
screenshot --annotate在截图上给交互元素叠编号[N],与@eN一一对应,供多模态模型参考视觉布局; - 会话隔离:
--session <name>每个会话拥有独立浏览器实例、Cookie、存储、历史与认证状态;--pin-tab在共享 CDP 时把会话严格绑定到自己的标签页,标签关闭即报tab_gone而不是误操作别的标签; - 录制与接触表:
recording抓取操作过程,contact sheet 按时间戳拼出关键帧并用红框标出变化区域(见首图); - 流式视频预览:WebMCP 模式下官方给出的帧体积口径为 1280×720、质量 80 约 54KB/帧,质量 20 约 25KB,质量 20 且 640×360 约 9KB,
maxFps范围 1–120; - MCP server:
agent-browser mcp以 stdio 暴露工具,默认 MCP 协议版本 2025-11-25,工具分 core/network/state/debug/tabs/react/mobile 等 profile,默认只开 core 以控制上下文体积; - 安全(全部 opt-in):AES-256-GCM 加密落盘会话状态、域名白名单
--allowed-domains、静态动作策略文件、敏感动作确认、--max-output截断上下文、加密凭证保险库(LLM 看不到密码)。
四、关键数据:可核对的官方数字
| 数字 | 口径与来源 |
|---|---|
| snapshot 约 200–400 tokens vs 整 DOM 约 3000–5000 tokens | 官方文档站估算,非独立基准,随页面变化 |
| WebMCP 自动摘要上限 | 16 个工具、4 KiB JSON、工具描述截断到 160 字节(README) |
| 轻量 Chromium 体积 | @sparticuz/chromium 约 50MB,对比打包 Chromium 约 684MB(README serverless 章节) |
| iOS 模拟器首启 | 约 30–60 秒,后续命令较快(README iOS 章节) |
| 示例 a11y 审计 | 24 passes / 2 violations(README 演示输出,非性能基准) |
| 定时自动保存间隔 | 默认 30000ms;状态文件默认 30 天过期 |
五、评测方法批判:官方数字哪些不能外推
- token 对比是页面相关的估算:200–400 与 3000–5000 是官方在示例页面上的口径,长页面、复杂表单、大量嵌入式控件都会抬高两侧数值,不能当作固定压缩比写进方案。
- 54KB/9KB 是特定分辨率与质量档位:帧体积随分辨率、质量、画面运动幅度变化,流式预览的带宽预算必须按自己的目标档位实测。
- 50MB vs 684MB 是体积对比不是性能对比:轻量 Chromium 换来的是包体与冷启动,兼容面比完整 Chromium 窄。
- a11y 的 24/2 是 demo 输出:只说明 axe-core 跑通,不代表审计覆盖率或站点合规率;axe 自身无法判断的规则会进
incomplete待人工复核。 - 没有发布独立跑分:官方未提供与 Playwright/Puppeteer 的速度、成功率对照测试,本文不替它编造对比数字。
六、适用 / 不适用场景
适合:
- 让 Claude Code、Codex 等 MCP Agent 直接操作内网工具、后台页面,又不希望模型拼脆弱选择器的团队;
- 需要多 Agent 并行、每个 Agent 独立会话与登录态的自动化测试;
- 想把浏览器能力接进 MCP 生态,同时需要域名白名单、输出截断等安全边界的场景;
- 追求 daemon 常驻、命令间复用浏览器以降低延迟的流水线。
不适合:
- 需要 Safari/WebDriver(iOS 模拟器)上的标注截图:官方明确该后端暂不支持
--annotate; - 依赖 WebGPU 的 three.js/Babylon.js 页面在普通 headless 下直接截图(默认渲染黑图,需
--webgpu,且 Linux 上走 SwiftShader 软件 Vulkan); - 想在 CDP 外接、浏览器复用 profile、状态回放等路径上启用域名白名单:官方说明这些场景无法在页面脚本运行前安装隔离层,白名单被拒绝;
- 把
obscura引擎当生产选项:README 标注 experimental,且拒绝代理绕过规则。
七、客观分析:优势与局限
优势:
- 定位范式贴合模型:无障碍树引用把”指元素”变成读编号,规避类名混淆与 DOM 膨胀,这是相对 Playwright 式选择器的核心差异;
- 架构轻:纯 Rust daemon、无 Node 依赖,常驻复用,分发体积与冷启动友好;
- Agent 视角的工具面完整:MCP profile 分层、
--json结构化输出、delta snapshot、录制接触表都为”模型消费”设计,而非仅给人看; - 安全开关齐全且默认关闭:白名单、加密、动作策略、输出截断都需要显式开启,不干扰既有工作流;
- 生态接口开放:插件系统以 stdio JSON 协议外接验证码、保险库、云浏览器 provider。
局限:
- 引擎能力不均:chrome 完整,lightpanda 是轻量化取向,obscura 实验性,Safari/iOS 只覆盖基础控制且无标注截图;
- 实验特性边界清楚:WebMCP 默认对本地 Chrome 开启但标注 experimental,自动摘要有 16 工具/4KiB/160 字节硬上限;
- WebGPU 是已知坑:Windows/Linux headless 默认黑图,需要额外 flag 且无硬件加速时走软件渲染;
- 域名白名单覆盖窄:CDP、auto-connect、profile 复用、状态回放、iOS、Safari 均被排除;
- 项目年轻:命令面很大,文档分散在 README 与子文档,生产采用前应自行做回归验证。
八、它意味着什么 / 谁该关注
agent-browser 代表浏览器自动化从”人写选择器脚本”向”Agent 读语义树发指令”迁移的一条具体路线:不是再包一层 Playwright,而是把输出格式本身改造为模型友好。值得关注:构建内部 Agent 操作平台的工程团队、MCP 工具作者、需要隔离会话与安全边界的自动化测试负责人。试用建议先从默认 core profile 与 snapshot -i 起步,确认目标站点在 chrome 引擎下行为符合预期,再逐步开启白名单与加密等安全项。