ActorCore(今 Rivet):把"有状态 Serverless"做到 20ms 冷启动
阅读时间: 大约 11 分钟
ActorCore(今 Rivet):把”有状态 Serverless”做到 20ms 冷启动
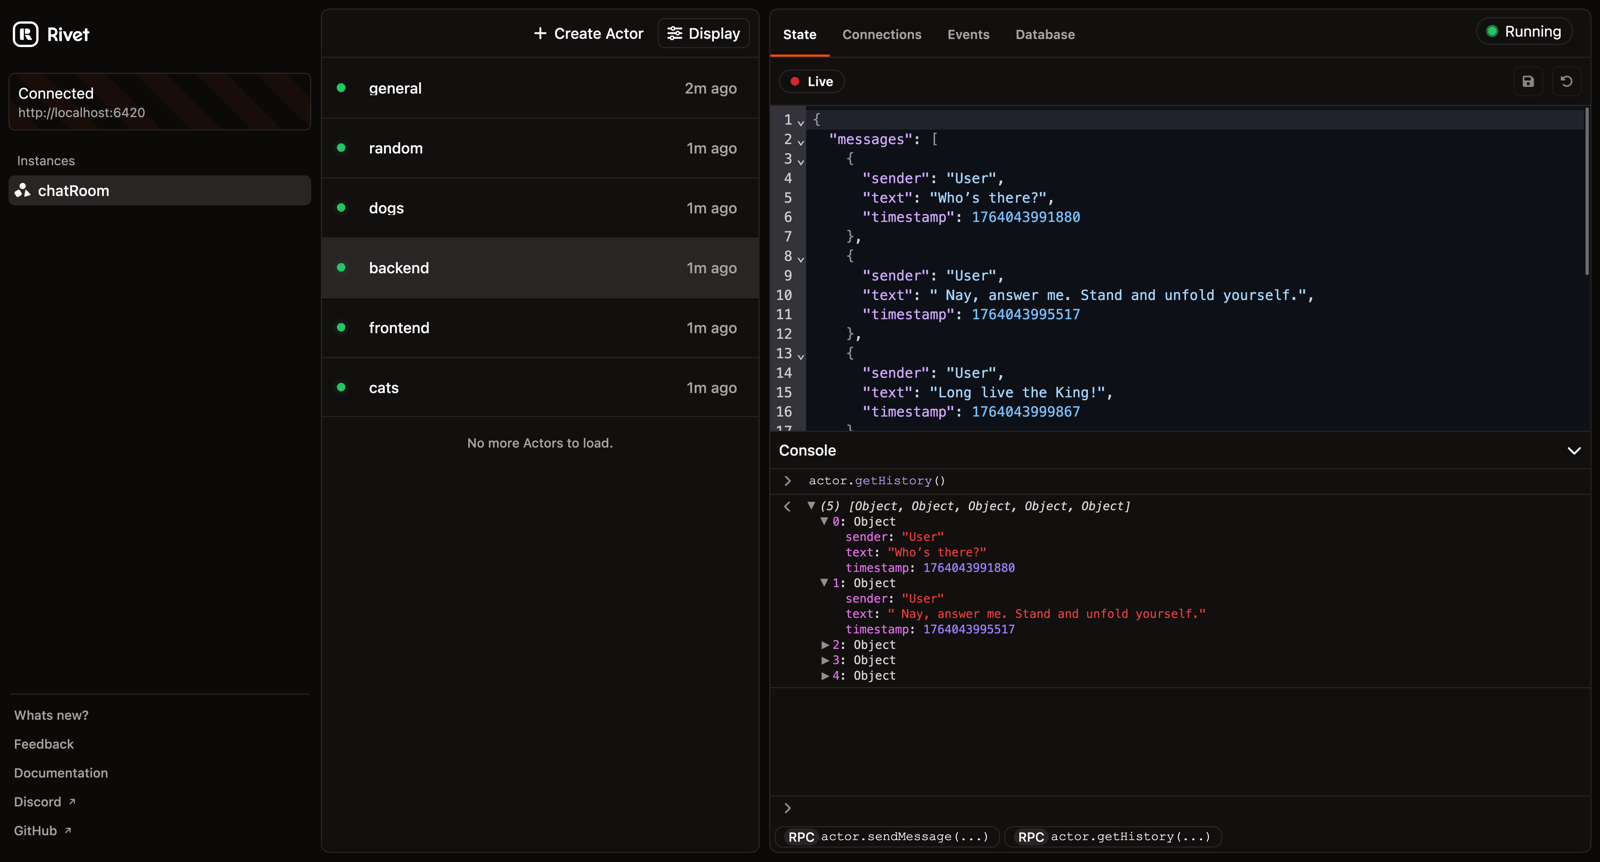
Serverless 世界长期有个尴尬:函数是无状态的,每次调用都要重新连数据库、重载上下文,冷启动慢、状态要外置。而 AI Agent、协作文档、实时聊天这类应用,恰恰是”一个会话/一个用户就是一个常驻小服务”的形态——它们天然有状态。ActorCore 的主张就是把这个矛盾反过来:让每个计算单元像一台微型服务器,在请求之间记住数据,无需每次重载,也无需外接数据库或 ORM。Koala 在周报里介绍它”由 Rivet 团队开发,可部署到 Rivet、Cloudflare、Bun、Node.js”。需要说明的是:本文调研时 actorcore.org 已无法解析(DNS 失败),项目实际已演进为 GitHub 上的 rivet-dev/rivet(npm 包名 rivetkit),下文数据均来自其官方仓库 README。
一、背景:无状态 Serverless 为什么不够用
传统 FaaS(如 AWS Lambda)为了弹性扩缩,把函数设计成”无状态、用完即弃”。这对短周期 API 很好,但对三类应用很别扭:
- AI Agent:多轮对话要记住完整上下文,每次冷启动重新加载系统提示和记忆,又慢又贵;
- 协作/实时应用:一个房间、一份文档需要 WebSocket 长连接和广播,无状态函数做不到;
- 本地优先应用:状态应该跟计算在一起,而不是跨网络往返一个外部数据库。
Actor 模型(源自 Erlang)的答案是:把”一个长期运行的轻量进程”作为基本单元,状态就在进程内存里,进程间靠消息通信。ActorCore/Rivet 把这个老思想搬到了现代 JS/TS 云原生运行时上。
二、它是什么:一个 Actor 就是一切
按官方 README,Rivet Actor 的定义是:“long-running, lightweight processes designed for stateful workloads. State lives in-memory with automatic persistence.” 你可以为每个 Agent、每个会话、每个用户创建一个 Actor,它自带状态、存储与网络。代码形态非常简洁:
const agent = actor({
  state: { messages: [] as Message[] },   // 内存态,自动持久化
  run: async (c) => {
    for await (const msg of c.queue.iter()) {
      c.state.messages.push({ role: "user", content: msg.body.text });
      const response = streamText({ model: openai("gpt-5"), messages: c.state.messages });
      for await (const delta of response.textStream) c.broadcast("token", delta);  // 实时广播
      c.state.messages.push({ role: "assistant", content: await response.text });
    }
  },
});
关键设计点:状态直接是一个 JS 对象,自动持久化到 SQLite(或自带数据库),不需要你写 ORM、不需要建表。这正是 Koala 说的”直接用 JavaScript 对象或 SQLite 即可”。
三、内置能力:不止是状态
官方列出 Actor 原生支持:
- WebSockets:实时双向流内建;
- Workflows:多步操作,自动重试;
- Queues:可靠的持久化消息队列;
- Scheduling:Actor 内的定时器与 cron;
- 生命周期:活跃时长驻、空闲休眠、可缩到零,因此空闲成本为零。
配套的可观测性工具(见首图 Inspector)包括:SQLite Viewer(实时查 Actor 数据库)、Workflow State(看每一步进度与重试)、Event Monitoring(追踪每次状态变更)、REPL(直接调用动作、订阅事件)。
四、关键数据:官方基准对比
README 给了两张对比表,数字很有冲击力(官方口径):
| 指标 | Rivet Actor | Kubernetes Pod | 虚拟机 |
|---|---|---|---|
| 冷启动 | ~20ms | ~6s | ~30s |
| 单实例内存 | ~0.6KB | ~50MB | ~512MB |
| 空闲成本 | $0 | ~$85/月(集群) | ~$5/月 |
| 水平扩展 | 无限 | ~5k 节点 | 手动 |
| 多区域 | 全球边缘 | 单区域 | 单区域 |
| State 指标 | Rivet Actor | Redis | Postgres |
|---|---|---|---|
| 读取时延 | 0ms | ~1ms | ~5ms |
五、评测方法批判:这些数字为什么要打个折扣
这是本文最该较真的部分。上面那张表很诱人,但它是厂商自测,且几个对比存在口径问题:
- “读取时延 0ms”是偷换概念。 Redis/Postgres 的 ~1ms/~5ms 是”跨网络访问外部数据库”的时延;Rivet 的 0ms 是”读自己进程内存”。把”内存变量”和”网络数据库”放一张表里比读延迟,结论必然是内存赢——这不是公平的基准,而是在陈述”状态与计算共址”这一设计本身。
- “单实例 ~0.6KB 内存”指的是 Actor 对象的开销,不是一个真实运行进程的驻留内存。它对比的对象却是 Pod 的 ~50MB、VM 的 ~512MB——一个空 actor 句柄 vs 一个完整操作系统容器,口径不对等。
- 冷启动 ~20ms成立的前提是 Actor 已经被休眠(hibernate)而非真的从零拉起一个新进程/容器;它对比的 K8s Pod ~6s、VM ~30s 是另一种量级的东西。
- **“空闲成本 $0”**依赖缩容到零的调度,而这个调度在自托管时需要你自己保证引擎可用;官方云的免费空闲也是商业引流口径。
- 官方 README 自己也留了一句 “Benchmark details & methodology” 的链接,说明他们意识到方法论需要单独交代——读者应点进去看测试条件,而不是直接引用这张表做技术选型。
六、优势与局限
优势:
- 状态与计算共址:Agent/协作类应用不用再外挂数据库,代码极大简化;
- 冷启动与闲置成本极低:休眠 Actor 让”每个用户一个常驻服务”在经济上可行;
- Workflows/Queues/Scheduling/WebSocket 内建:少拼装一堆中间件;
- 多部署形态:库模式本地跑(
npm install rivetkit)、自托管(单个 Rust 二进制或 Docker,支持 Postgres/文件系统/FoundationDB)、官方全球边缘云,且 Apache-2.0 允许自托管与云迁移,避免厂商锁定。
局限:
- 基准是厂商口径:如上节,0ms/~0.6KB 等数字需谨慎引用;
- 项目更名/迁移的不确定性:
actorcore.org已失效,文档与 API 在向 Rivet/rivetkit 收敛,旧资料可能过时; - 有状态 Actor 的一致性与运维:多副本下的状态同步、Actor 崩溃恢复、消息投递语义,自托管时需要深入理解其存储后端(Postgres/FoundationDB);
- 生态较新:仓库由少数核心维护者主导(最近提交者显示 2 people / NathanFlurry),生产案例规模仍需观察。
七、适合谁
- 构建多轮 AI Agent / Agent 工作流平台:每个 Agent 一个 Actor,状态持久化、可调度工具调用,正中靶心;
- 实时协作/聊天/文档:一个房间一个 Actor 做广播与持久化历史;
- 本地优先 / 多租户低延迟应用:每租户一个 Actor,内存态读、SQLite 持久化;
- 不适合:需要严格外部 SQL 查询、跨 Actor 复杂事务、或把内存态当成强一致数据库来用的场景——那还是该老老实实上 Postgres。
八、它意味着什么
ActorCore/Rivet 代表了”有状态 Serverless”这个正在升温的方向:用 Actor 模型把 AI Agent、实时协作这类长连接、强状态应用的基础设施复杂度收敛掉,让开发者像写一个对象一样写一个常驻服务。它的 20ms 冷启动、零闲置成本虽然是厂商口径,但背后的设计直觉是对的——下一代实时应用的单位,可能不再是”无状态函数 + 外部数据库”,而是”一个有状态的微型 Actor”。对正在做 Agent 产品的团队,它值得放进技术选型对比清单;但引用它的基准数字时,请记得那是”内存对比数据库”的胜利,而不是万能。